ხელოვნური ინტელექტი ფრილანსერების საქმეს უკვე 41%-ით ასრულებს
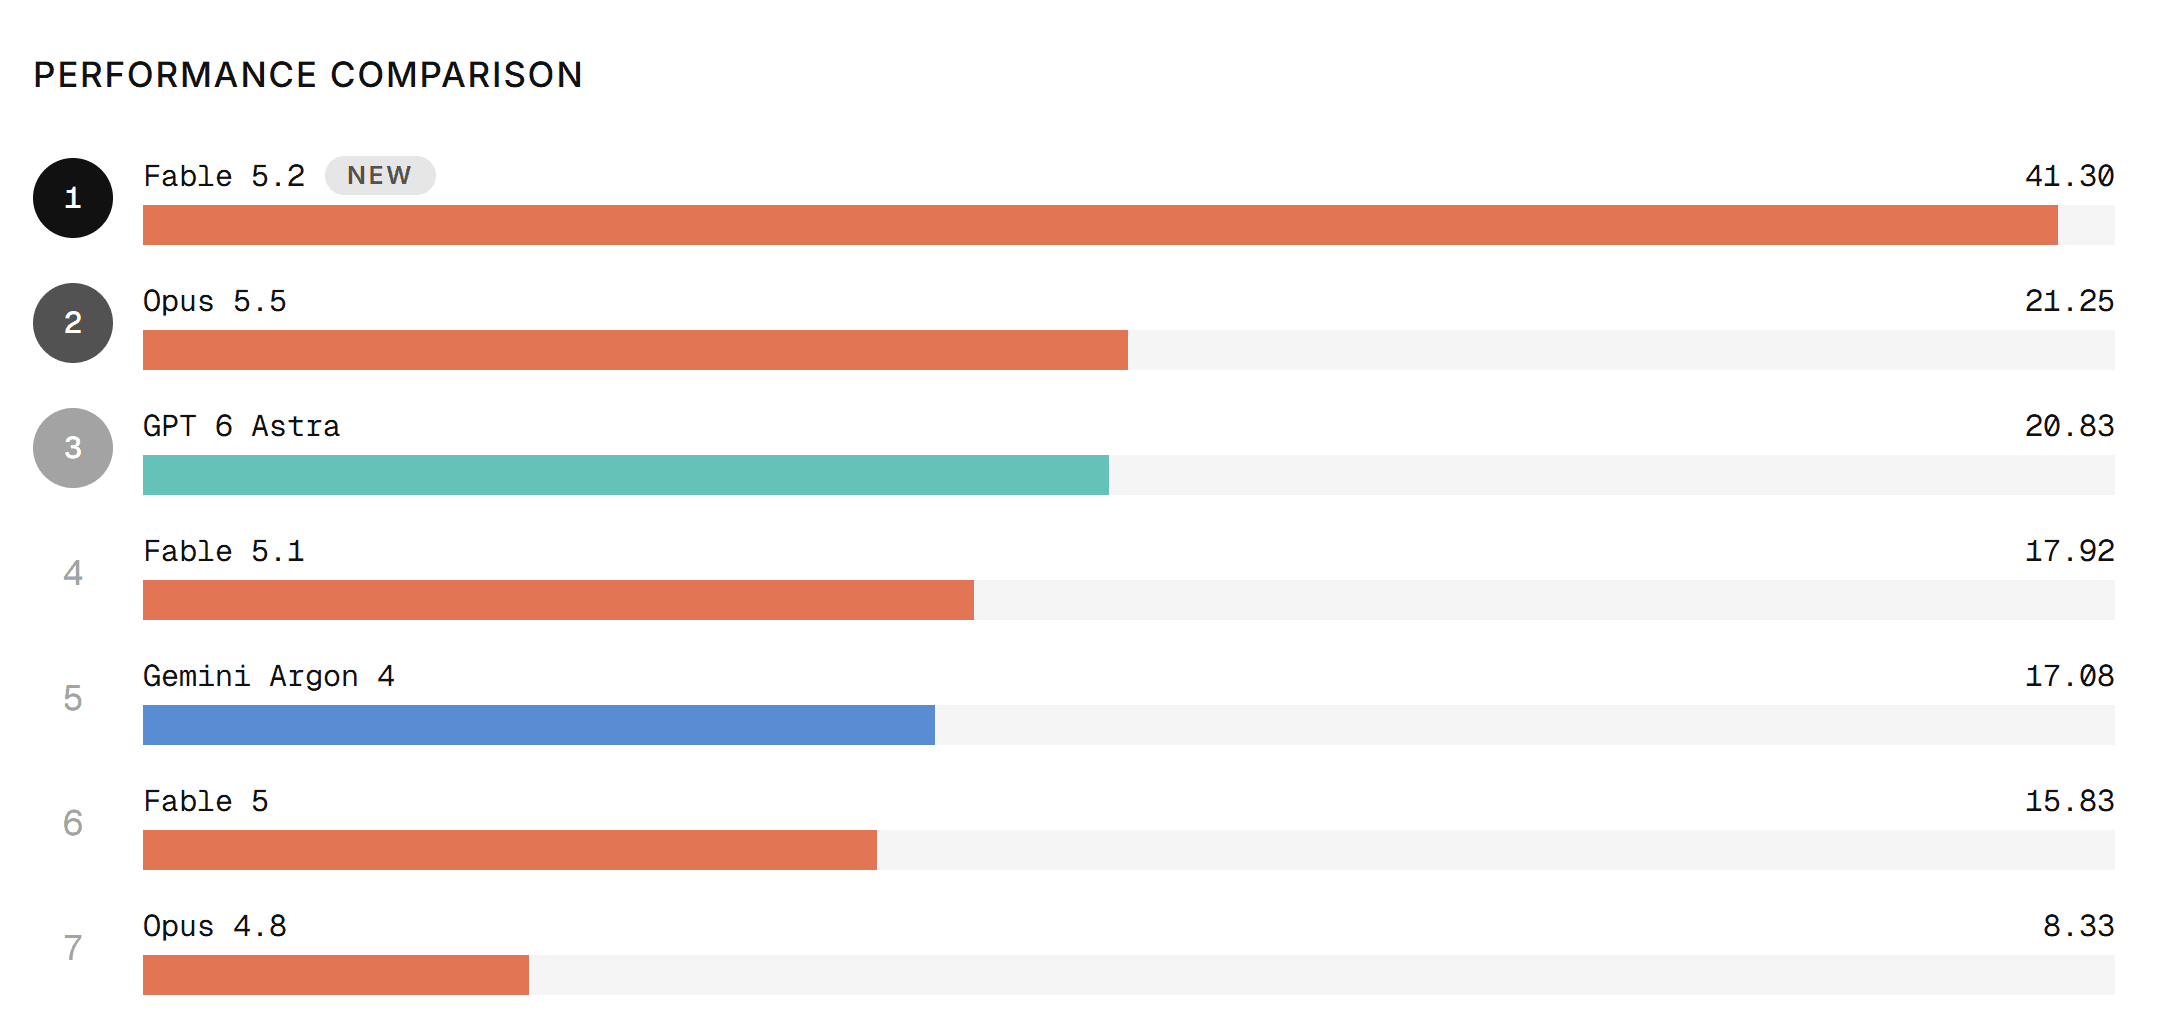
ხელოვნური ინტელექტის განვითარება ახალ ეტაპზე გადავიდა. Scale Labs-ისა და ხელოვნური ინტელექტის უსაფრთხოების ცენტრის (CAIS) მიერ ჩატარებულ Remote Labor Index-ის (RLI) კვლევაში, Anthropic-ის უახლესმა მოდელმა Fable 5.2-მა შთამბეჭდავი შედეგი აჩვენა. სისტემამ რეალური ფრილანსერული სამუშაოების 41.3%-ის შესრულება შეძლო ისეთი ხარისხით, რომ კლიენტები მას პროფესიონალურ ნამუშევრად ჩათვლიდნენ.
რევოლუციური ნახტომი პროდუქტიულობაში
მხოლოდ ერთი წლის წინ, როდესაც ეს ტესტირება პირველად დაიწყო, საუკეთესო AI აგენტები დავალებების მხოლოდ 2.5%-ს უმკლავდებოდნენ. Fable 5.2-ის დღევანდელი მაჩვენებელი ნიშნავს, რომ ხელოვნური ინტელექტი 16-ჯერ უფრო ეფექტური გახდა. პროგრესი განსაკუთრებით თვალსაჩინოა ბოლო რამდენიმე თვის განმავლობაში: ივლისში Anthropic-ის წინა მოდელი, Fable 5, დავალებების 16%-ს ასრულებდა, რაც იმ დროისთვის უკვე დიდ მიღწევად ითვლებოდა.
ამჟამად Fable 5.2 კონკურენტებს მნიშვნელოვნად უსწრებს. რეიტინგში მეორე ადგილზე Anthropic-ის Opus 5.5-ია (21.25%), ხოლო მესამეზე OpenAI-ის GPT 6 Astra (20.83%). Google-ის მოდელმა, Gemini Argon 4-მა, 17.08%-ით მეხუთე ადგილი დაიკავა. ეს მონაცემები ადასტურებს, რომ Fable 5.2 თითქმის ორჯერ უფრო წარმატებულია, ვიდრე ბაზარზე არსებული სხვა წამყვანი სისტემები.
რა შეუძლია ახალ მოდელს?
Scale Labs-ის ცნობით, Fable 5.2 განსაკუთრებულად ეფექტურია აუდიოსა და მუსიკის რედაქტირებაში, არქიტექტურულ დიზაინში, ინტერიერის დაგეგმარებასა და 3D მოდელირებაში. მოდელი წარმატებით ართმევს თავს კომპლექსურ, ხანგრძლივ პროექტებს, რომლებზეც წინა თაობის სისტემები ხშირად მარცხდებოდნენ. ტესტირების ფარგლებში AI-მ შეასრულა 50-მდე ისეთი დავალება, რომელსაც მანამდე არცერთი ხელოვნური ინტელექტი არ გაუმკლავებია.
მიუხედავად ამისა, სისტემას ჯერ კიდევ აქვს სუსტი მხარეები. ის კვლავ უჭირს ინდუსტრიული პროდუქტების დიზაინი და ანიმაციები. როდესაც AI აგენტი მარცხდება, შედეგი ხშირად არის არასრული, ტექნიკურად ხარვეზიანი ან არაპროფესიონალური ხარისხის.
როგორ ამოწმებენ შედეგებს?
RLI-ის ტესტირება განსხვავდება სხვა სტანდარტული შეფასებებისგან, რადგან ის აფასებს არა ცალკეულ უნარებს, არამედ სრულფასოვან სამუშაო პროცესს. მკვლევრებმა გამოიყენეს 240 რეალური პროექტი Upwork-ის პლატფორმიდან, რომელთა საერთო ღირებულება 144 000 დოლარს აღწევს. თითოეულ დავალებას ადამიანები საშუალოდ 29 საათს ანდომებენ.
მნიშვნელოვანია, რომ შედეგების შემოწმება ხდება არა სხვა AI-ის, არამედ გამოცდილი ადამიანების მიერ. ექსპერტები ხსნიან AI-ის მიერ შესრულებულ ფაილებს პროფესიონალურ პროგრამებში (როგორიცაა Blender, GIMP ან Audacity) და ადარებენ მათ ადამიანების მიერ შესრულებულ ანალოგიურ ნამუშევრებს. მკვლევრების თქმით, AI-ის მიერ AI-ის შეფასება ჯერჯერობით არასანდოა, რადგან ავტომატური სისტემები ხშირად ვერ ამჩნევენ ტექნიკურ ხარვეზებს, თუ ვიზუალურად ნამუშევარი მოწესრიგებულად გამოიყურება.
ეს მიღწევა კიდევ ერთხელ ადასტურებს, რომ ხელოვნური ინტელექტი სულ უფრო ახლოს მიდის ფრილანსერული ბაზრის რეალურ მოთხოვნებთან. ქართველი მომხმარებლებისთვის და ტექნოლოგიური სექტორისთვის ეს ნიშნავს, რომ უახლოეს წლებში რუტინული პროფესიონალური სამუშაოების ავტომატიზაცია კიდევ უფრო მასშტაბური გახდება.