AI კოდირების აგენტები: რატომ ვერ ცვლიან ისინი სრულფასოვან პროგრამისტებს
რეალური სამუშაო გარემო და AI-ის შეზღუდვები
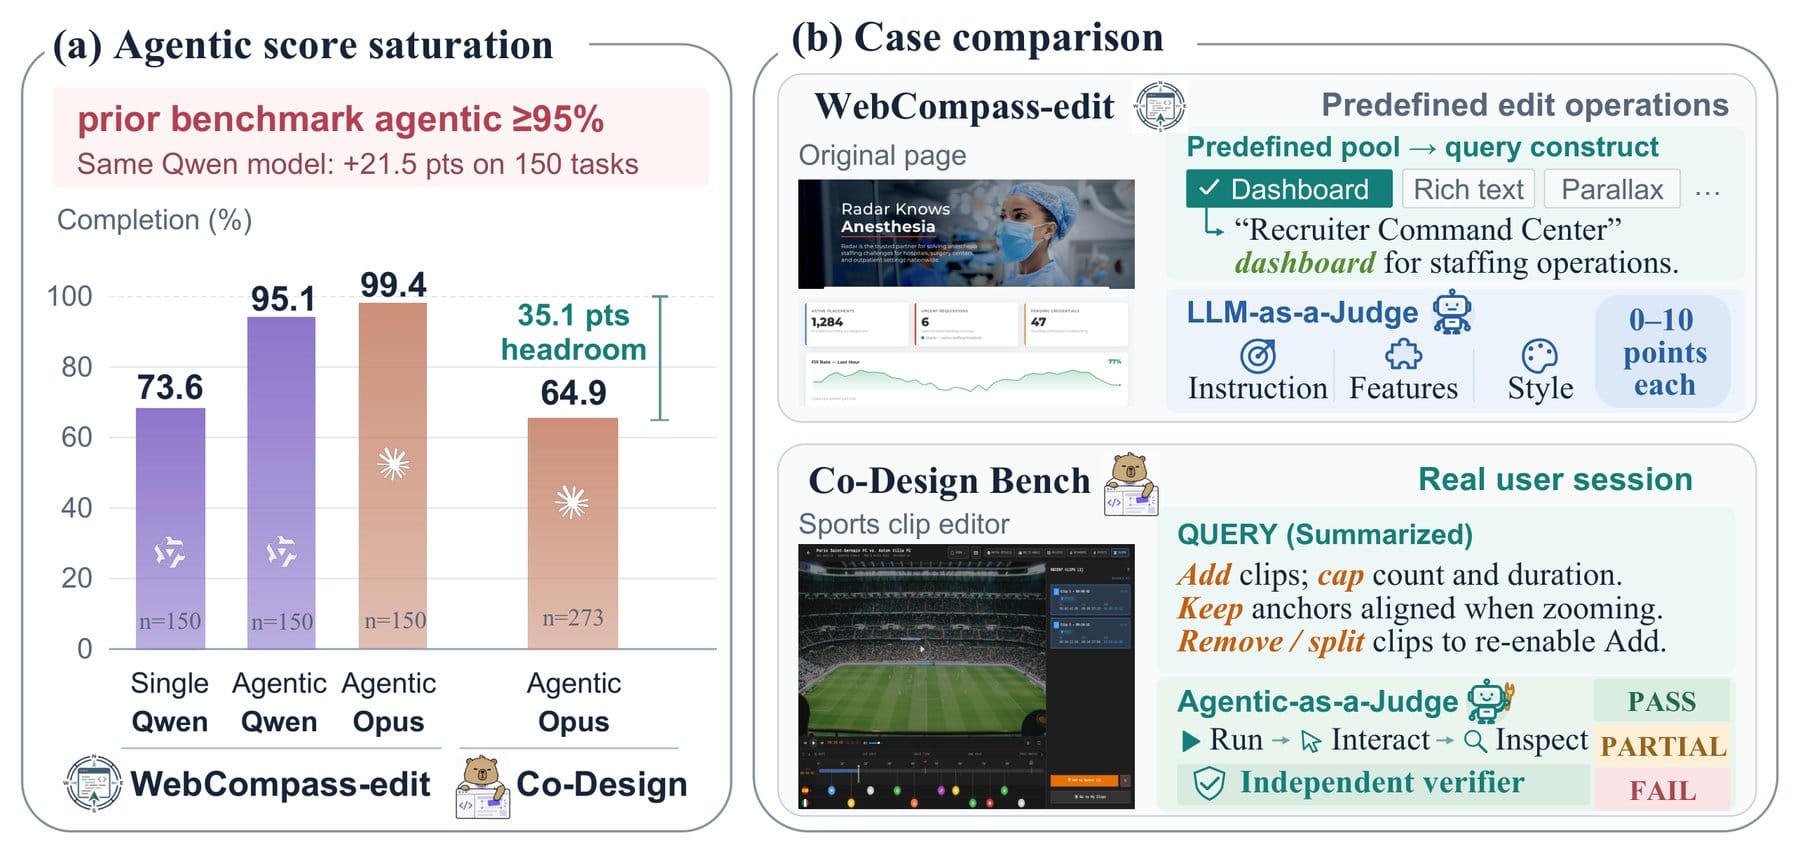
ხელოვნური ინტელექტის განვითარებამ პროგრამირების სფეროში რევოლუციური ცვლილებები მოიტანა, თუმცა უახლესი კვლევა გვაჩვენებს, რომ ეიფორიის საფუძველი ჯერ კიდევ არ გვაქვს. ალიბაბასა და რამდენიმე აზიური უნივერსიტეტის მკვლევართა ჯგუფმა შეიმუშავა ახალი ტესტირების სისტემა, სახელად Co-Design Bench, რომელიც აფასებს, თუ რამდენად ეფექტურად უმკლავდებიან AI აგენტები რეალურ პროგრამულ დავალებებს. შედეგები აჩვენებს, რომ ყველაზე მოწინავე მოდელებიც კი, როგორიცაა GPT-6 Astra, დავალებებს სრულყოფილად მხოლოდ 26.4%-ში ასრულებენ.
ტრადიციული ტესტებისგან განსხვავებით, სადაც მოდელები ხშირად 99%-ზე მაღალ მაჩვენებლებს აფიქსირებენ, Co-Design Bench ეყრდნობა რეალურ მომხმარებელთა მოთხოვნებს. ეს მოთხოვნები მოიცავს ვებ-აპლიკაციების რედაქტირებას, სადაც შეყვანის სახით გამოიყენება არა მხოლოდ ტექსტი, არამედ გამოსახულებები, აუდიო და ვიდეო მასალები. ასეთი მიდგომა უფრო ზუსტად ასახავს იმ სირთულეებს, რომლებსაც დეველოპერები ყოველდღიურ საქმიანობაში აწყდებიან.
რატომ არის საჭირო ადამიანის მეთვალყურეობა?
კვლევის მიხედვით, მიუხედავად იმისა, რომ AI აგენტები დავალების დიდ ნაწილს წარმატებით ართმევენ თავს, ისინი თითქმის ყოველთვის ტოვებენ მცირე, მაგრამ კრიტიკულ ხარვეზებს. ეს ნიშნავს, რომ პროგრამისტებს მაინც უწევთ კოდის გადახედვა და ხელით გასწორება. GPT-6 Astra, რომელიც ტესტირებაში საუკეთესო აღმოჩნდა, დავალების მოთხოვნების საშუალოდ 70%-ს აკმაყოფილებს, თუმცა სრული შედეგი იშვიათია.
მკვლევარები აღნიშნავენ, რომ დავალებების სირთულე იზრდება, როდესაც ერთ პროექტში გაერთიანებულია დიზაინის, ინტერაქციისა და შინაარსობრივი ცვლილებები. ასეთი კომპლექსური მოთხოვნები რეალურ სამყაროში სტანდარტულია. საინტერესოა, რომ მეტი გამოთვლითი რესურსის დახარჯვა ყოველთვის არ იძლევა უკეთეს შედეგს. მაგალითად, GLM-5.2 მოდელი ექვსჯერ მეტ რესურსს მოიხმარს, ვიდრე GPT-6 Astra, თუმცა შედეგით მას მნიშვნელოვნად ჩამორჩება.
გარემო და შედეგები: რას უნდა მიაქციონ ყურადღება კომპანიებმა?
კვლევამ ასევე გამოავლინა, რომ მოდელის ეფექტურობა დამოკიდებულია არა მხოლოდ თავად ალგორითმზე, არამედ იმ გარემოზე (harness), რომელშიც ის ფუნქციონირებს. ერთი და იმავე მოდელის შედეგები შეიძლება რადიკალურად განსხვავდებოდეს იმის მიხედვით, თუ რა პროგრამულ გარემოში წერს და ასრულებს ის კოდს. ამიტომ, კომპანიებმა, რომლებიც AI-ს დანერგვას გეგმავენ, აუცილებლად უნდა შეაფასონ მოდელი და სამუშაო გარემო, როგორც ერთიანი სისტემა.
მიუხედავად იმისა, რომ ხელოვნური ინტელექტი უკვე წარმოადგენს ძლიერ დამხმარე იარაღს, ის ჯერჯერობით ვერ ანაცვლებს კვალიფიციურ სპეციალისტს. რეალური სამუშაო პროცესები გაცილებით მოქნილი და არაპროგნოზირებადია, ვიდრე აკადემიური ტესტები. ქართველი დეველოპერებისთვის ეს ნიშნავს, რომ AI ინსტრუმენტების გამოყენება ზრდის პროდუქტიულობას, თუმცა საბოლოო ხარისხის უზრუნველყოფა და კოდის სრულყოფა კვლავ ადამიანის კომპეტენციაში რჩება.